
Precio de GPT-6.2 Astra: 8 $ de entrada y 40 $ de salida, un 20% menos
Precio de GPT-6.2 Astra: 8 $ / 0,40 $ en caché / 40 $ por 1M tokens, un 20% menos que GPT-6 Astra. Sol sigue en 2 $/10 $. Ultrafast es promo.
 bufferSobre el autor9 min de lectura
OpenAI anunció GPT-6.2 Astra y GPT-6.2 Sol a las 09:54 PT del 17 de noviembre de 2026 (01:54 del 18 de noviembre, hora de Pekín). La publicación oficial de ese mismo momento empezaba así: “Some of you have been asking very politely. Some of you have just been asking. GPT-6.2 Astra and Sol are now available.”
Si hay que calcular un coste, lo primero son las tarifas de la API. La página de lanzamiento fija el precio de GPT-6.2 Astra en 8 $ de entrada, 0,40 $ de entrada en caché y 40 $ de salida, por millón de tokens. Eso es un 20% menos que GPT-6 Astra en entrada y salida, y un 60% menos en la entrada en caché. GPT-6.2 Sol mantiene las tarifas de GPT-6.1 Sol: 2 / 0,10 / 10 $. Contrasté esas cifras con la página de precios para desarrolladores y con las fichas de GPT-6.2 Astra y GPT-6.2 Sol. Las tarifas Standard de contexto corto de GPT-6 Astra eran 10 / 1,00 / 50 $, y encajan con esos recortes del 20% y del 60%. Las páginas oficiales solo publican precios en dólares estadounidenses; no hay un precio oficial en RMB.
Comprobado hacia las 03:50, hora de Pekín, del 18 de noviembre de 2026.
Quién puede usarlo y lo que las páginas oficiales no dicen
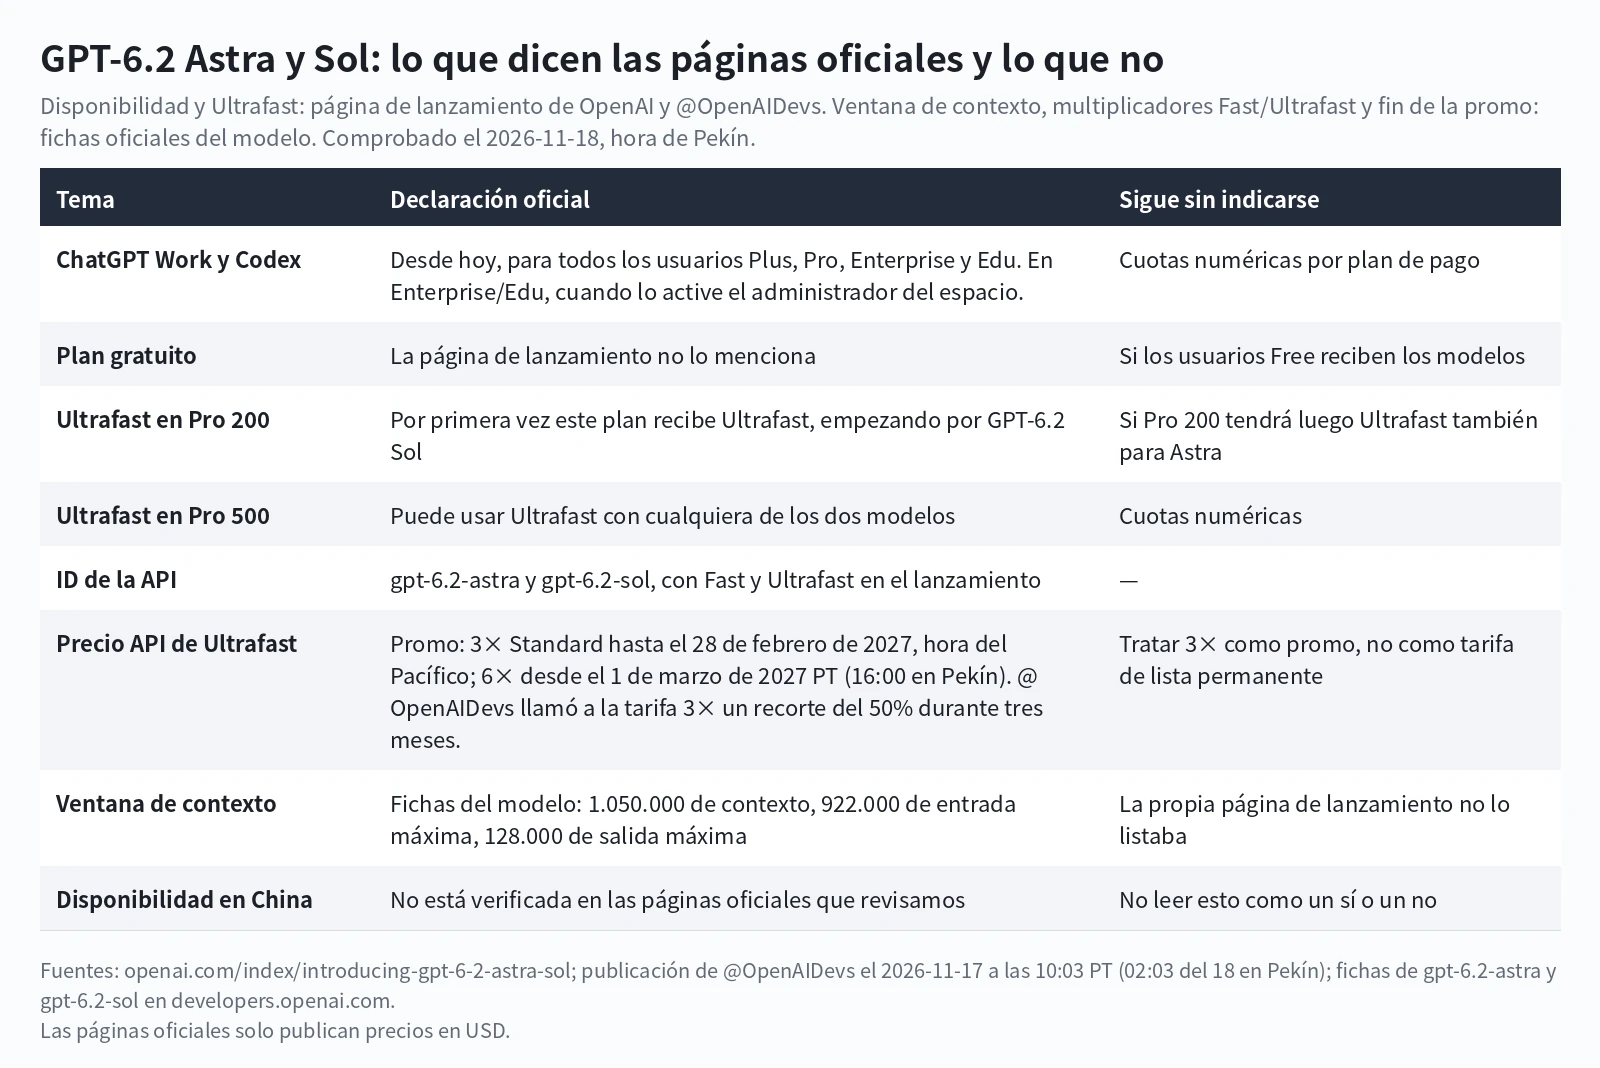
La página de lanzamiento indica que, a partir de hoy, GPT-6.2 Astra y Sol están disponibles para todos los usuarios Plus, Pro, Enterprise y Edu en ChatGPT Work y Codex. Los suscriptores de Pro 500 pueden usar Ultrafast con cualquiera de los dos modelos. Por primera vez, OpenAI también lleva Ultrafast a los suscriptores de Pro 200, empezando por GPT-6.2 Sol. En Enterprise y Edu, el acceso llega cuando el administrador del espacio de trabajo lo activa. Los desarrolladores pueden llamar a gpt-6.2-astra y gpt-6.2-sol en la API, con Fast y Ultrafast disponibles desde el lanzamiento.
La página de lanzamiento no menciona el plan gratuito. Tampoco publica cuotas numéricas de ChatGPT o Codex por plan de pago. Solo dice que los nuevos modelos usan menos tokens de salida, de modo que se puede hacer más dentro de los límites de uso actuales. No pude verificar la disponibilidad en China en las páginas oficiales que revisé, y este artículo no lo trata como un sí ni como un no.
La propia página de lanzamiento no indica la ventana de contexto. Las fichas oficiales del modelo sí: ambos modelos tienen una ventana de 1.050.000 tokens, un máximo de 922.000 de entrada y un máximo de 128.000 de salida.
Precio de GPT-6.2 Astra frente a GPT-6 Astra
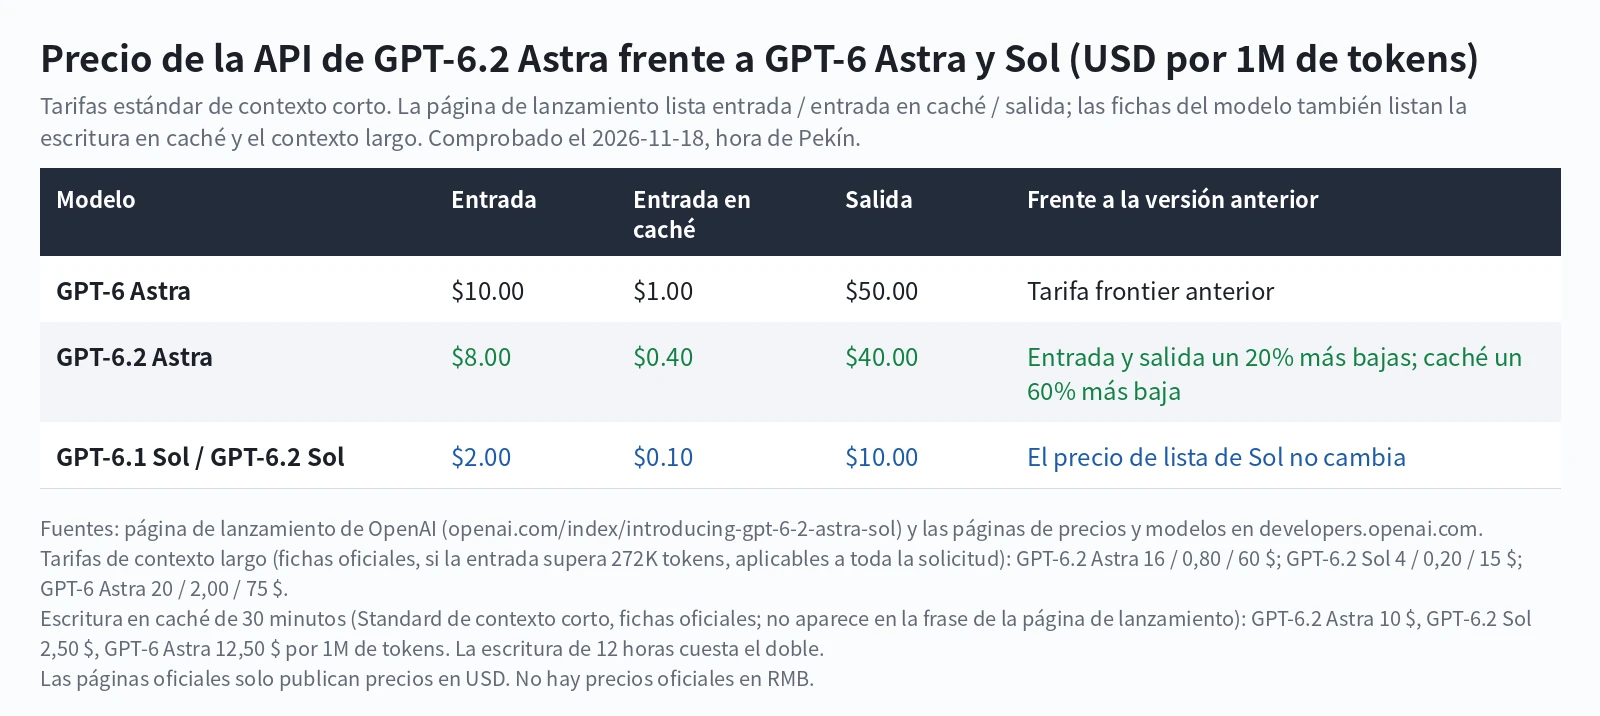
La página de lanzamiento solo lista las tres columnas de entrada, entrada en caché y salida. Las fichas del modelo y la página de precios añaden dos detalles que importan en una tarea de agente con mucho contexto.
Primero, cuando la entrada de una solicitud supera los 272K tokens, las tarifas de contexto largo se aplican a toda la solicitud: las de entrada y caché se duplican, y la de salida es 1,5 veces la de contexto corto. Así, GPT-6.2 Astra queda en 16 / 0,80 / 60 $, GPT-6.2 Sol en 4 / 0,20 / 15 $ y GPT-6 Astra en 20 / 2,00 / 75 $.
Segundo, la escritura en caché se factura aparte. A tarifas Standard de contexto corto, una escritura de 30 minutos cuesta 10 $ por millón de tokens en GPT-6.2 Astra, 2,50 $ en Sol y 12,50 $ en GPT-6 Astra. Una escritura de 12 horas cuesta el doble.
La tabla más amplia de seis proveedores está en nuestra comparativa de precios de API de LLM. Esa página todavía tiene las filas anteriores de GPT-6 Astra y GPT-6.1 Sol, y habrá que actualizarla cuando se apruebe este artículo.
Un trabajo de 10 turnos que calculé con las tarifas oficiales
Calculé un trabajo de agente de contexto largo con las tarifas Standard de contexto corto de la página de lanzamiento. El supuesto son 10 turnos: cada uno mantiene un prefijo de proyecto de 200.000 tokens, añade 8.000 tokens de entrada nueva y escribe 6.000 tokens de salida. En el primer turno el prefijo aún no está en caché, así que los 208.000 tokens de entrada se cobran a la tarifa sin caché. En los nueve turnos siguientes, los 200.000 tokens del prefijo se cobran como entrada en caché y los 8.000 nuevos siguen sin caché. 208.000 está por debajo del umbral de 272K, así que aplican las tarifas de contexto corto. Estas cantidades de tokens son mías, no una carga de trabajo oficial de OpenAI.
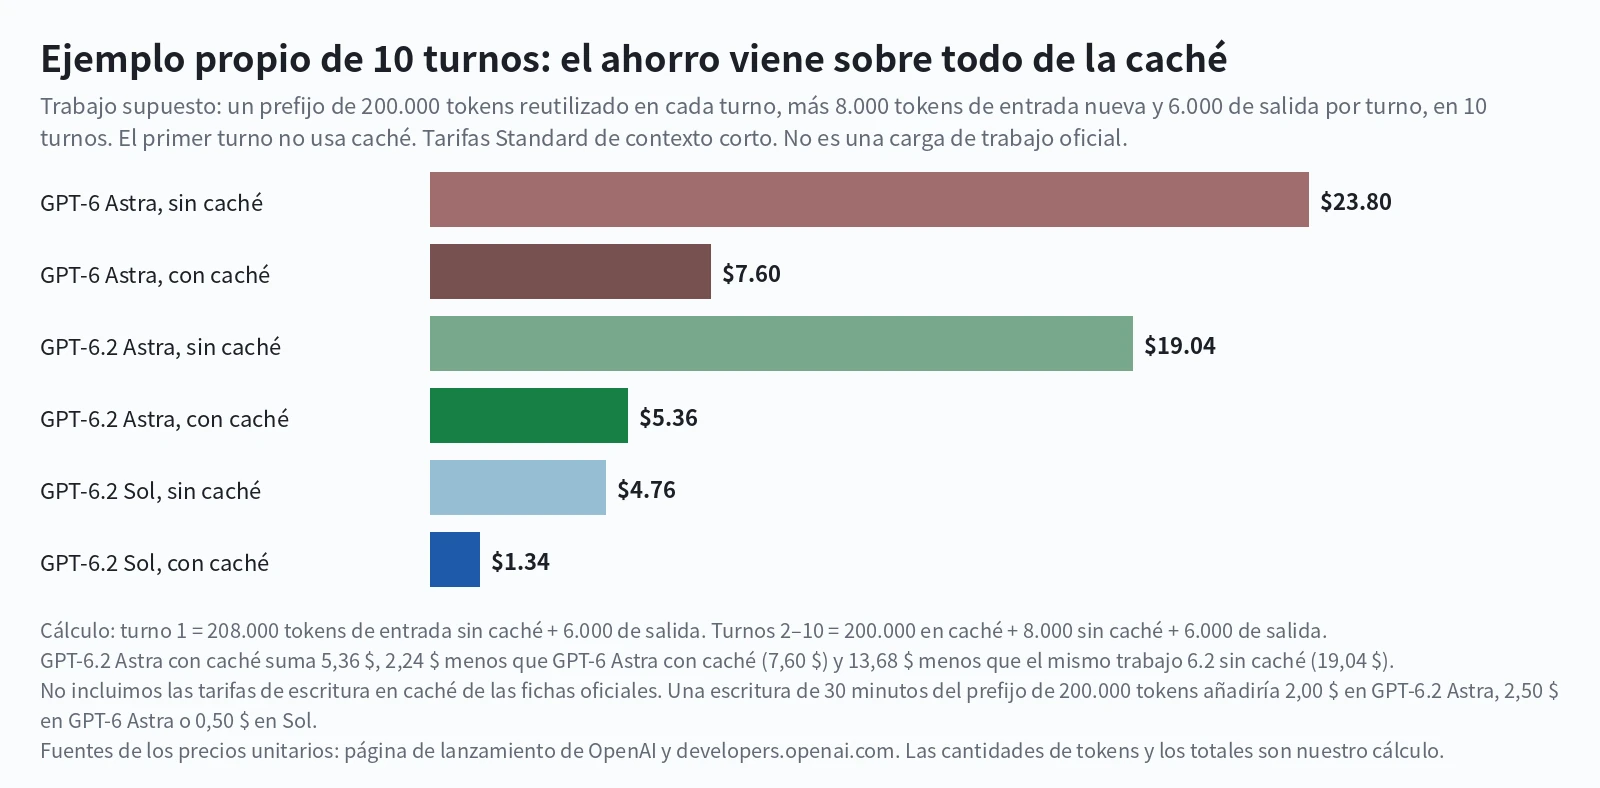
En la columna «con caché», el turno 1 se factura sin caché; solo los turnos 2 a 10 usan la tarifa de caché.
Con el precio de GPT-6.2 Astra de 8 / 0,40 / 40 $, el turno 1 es 208.000 × 8 / 1.000.000 + 6.000 × 40 / 1.000.000 = 1,904 $. Cada uno de los nueve turnos siguientes es 200.000 × 0,40 / 1.000.000 + 8.000 × 8 / 1.000.000 + 6.000 × 40 / 1.000.000 = 0,384 $. El total de los diez turnos es 5,36 $.
El mismo trabajo sin ninguna caché costaría 19,04 $, así que la caché ahorra 13,68 $ en este ejemplo. En GPT-6 Astra, a 10 / 1,00 / 50 $, el total con caché es 7,60 $ y el total sin caché es 23,80 $. En este trabajo supuesto, GPT-6.2 Astra sale 2,24 $ más barato que GPT-6 Astra, aproximadamente un 29% menos; la diferencia frente a correr 6.2 sin caché es mayor. GPT-6.2 Sol, con las mismas cantidades de tokens y el mismo supuesto de caché, suma 1,34 $ (o 4,76 $ sin caché). Ese precio de lista no cambia respecto a GPT-6.1 Sol.
Si el prefijo sube a 400.000 tokens (408.000 de entrada por turno, por encima de 272K), aplican las tarifas de contexto largo. Con el mismo patrón de 10 turnos y caché, GPT-6.2 Astra suma 14,16 $, GPT-6 Astra 21,30 $ y Sol 3,54 $. Ninguno de esos totales incluye las tarifas de escritura en caché. Una escritura de 30 minutos del prefijo de 200.000 tokens en el primer turno añadiría 2,00 $ en GPT-6.2 Astra, 2,50 $ en GPT-6 Astra o 0,50 $ en Sol.
La página de lanzamiento recomienda mantener sin cambios los prefijos del prompt y añadir las instrucciones nuevas al final, para reutilizar la caché, bajar coste y latencia, y conservar el razonamiento entre turnos.
Para la elección entre suscripción y API, véase ChatGPT Plus o API. Si esa página todavía calcula los ejemplos con las tarifas anteriores de Astra, habrá que revisarla después de publicar este artículo.
Ultrafast es un precio promocional, y Pro 200 lo recibe primero en Sol
@OpenAIDevs escribió a las 10:03 PT del 17 de noviembre (02:03 del 18, hora de Pekín) que OpenAI recorta el precio de Ultrafast un 50% durante los próximos tres meses, “making it available at just 3x the cost of Standard for API and Enterprise users.” Es una tarifa promocional, no el precio de lista permanente. Las fichas oficiales del modelo son más precisas: Ultrafast cuesta 3 veces la tarifa Standard hasta el 28 de febrero de 2027, hora del Pacífico, y 6 veces la tarifa Standard a partir del 1 de marzo de 2027, hora del Pacífico, que corresponde a las 16:00 del 1 de marzo en Pekín. El modo Fast cuesta el doble de la tarifa Standard; las fichas no describen una promoción de Fast.
Si se aplica a mi ejemplo de GPT-6.2 Astra de contexto corto con caché, de 5,36 $, Ultrafast costaría unos 16,08 $ durante la promo y unos 32,16 $ a la tarifa 6× cuando termine. Eso es el multiplicador oficial por mi ejemplo, no una cotización de OpenAI.
En ChatGPT y Codex, Pro 500 puede usar Ultrafast con cualquiera de los dos modelos. Pro 200 recibe Ultrafast por primera vez, empezando por GPT-6.2 Sol. Las páginas oficiales siguen sin publicar cuotas numéricas de esos planes. Las notas ya publicadas sobre los planes están en ChatGPT Go vs Plus o Pro.
Tibo, responsable de Codex (@thsottiaux), escribió a las 10:09 PT (02:09, hora de Pekín) que GPT-6.2 Sol y Astra por fin están aquí, que Ultrafast se ha ampliado a los planes Pro 200 para GPT-6.2 Sol, y que Sol es su modelo habitual para la mayor parte del trabajo cotidiano. En una respuesta posterior dijo que estos modelos son extremadamente eficientes, algo que se nota en la velocidad, el coste y hasta dónde llega el uso. Son comentarios suyos. No son un aviso de cuota ni un anuncio de reinicio.
Comparativas oficiales (autodeclaradas) y una salvedad de alineación
Las puntuaciones comparativas de la página de lanzamiento las reporta OpenAI. Las reescribo como tales; no son resultados que yo haya medido.
En Agents’ Last Exam, que evalúa trabajo profesional de varios pasos, OpenAI afirma que GPT-6.2 Astra puntúa 5,2 puntos por encima de GPT-6 Astra a menos de un tercio del coste, y 5,5 puntos por delante de Claude Fable 5.2 a un 5% del coste. La misma página indica que los resultados de Fable 5.2 en la clasificación excluyen nueve tareas que usaron un modelo de respaldo. En Terminal-Bench-Science 0.1, OpenAI afirma que 6.2 Astra puntúa 9 puntos porcentuales por encima de GPT-6 Astra a menos de un tercio del coste. En FrontierCode 2.0 de Cognition, dice que GPT-6.2 Sol queda a 0,5 puntos de 6.2 Astra a aproximadamente una quinta parte del coste, ambos en max. En LifeVal, una evaluación propia de OpenAI, dice que Sol supera a GPT-6 Astra a aproximadamente una séptima parte del coste.
La página de lanzamiento también indica que, en dos pruebas, ambos modelos eran más propensos que GPT-6 Astra a omitir mencionar obstáculos que bloqueaban su trabajo, como un archivo ausente o una herramienta de búsqueda no disponible. OpenAI dice que añadió instrucciones en Codex que reducen de forma sustancial esas omisiones, y que sigue investigando el comportamiento.
En ciberseguridad, OpenAI afirma que 6.2 Astra y Sol alcanzan el umbral Critical de su Preparedness Framework, y que se lanzan con salvaguardas más estrictas para la asistencia de ciberseguridad de mayor riesgo. Esas protecciones, según la compañía, también restringen algunos flujos legítimos de investigación de vulnerabilidades y de pruebas de seguridad. La página de lanzamiento remite a una system card para los métodos y los resultados completos. Una cifra circulada sobre una ganancia en ExploitBench Internal Port no es un número que yo haya podido verificar en el texto de la página de lanzamiento ni en las fichas del modelo que leí, así que no la cito aquí.
Lecturas relacionadas
Para la tabla de precios de lista de seis proveedores, véase la comparativa de precios de API de LLM. Para planes de ChatGPT frente al uso medido de la API, véase ChatGPT Plus o API y ChatGPT Go vs Plus o Pro. Para una comparación más amplia con los planes de Claude y Gemini, véase Qué suscripción de IA conviene.