

Artificial Analysis Intelligence Index: guía esencial de la v5, 9 pruebas y 4 categorías al 25 % (2026)
El Artificial Analysis Intelligence Index junta nueve pruebas independientes en una sola nota. La versión 5.0, vigente desde octubre de 2026, las reparte en trabajo del conocimiento, programación, ciencia y general, al 25 % cada una. Claude Opus 5.5 (Max) lidera con 58. Qué mide, qué cambió y cómo usarlo sin engañarse. Revisado el 28/10/2026.
 bufferSobre el autor5 min de lectura
Respuesta corta: el Artificial Analysis Intelligence Index es una nota única que calcula Artificial Analysis, una empresa independiente de benchmarks. Ejecuta ella misma nueve evaluaciones difíciles y las pondera. La versión 5.0 está vigente desde octubre de 2026 y reparte las pruebas en cuatro categorías: trabajo del conocimiento, programación, ciencia y general, con un 25 % cada una. A 28 de octubre de 2026, la página oficial pone primero a Claude Opus 5.5 (Max) con 58 puntos, seguido de Claude Opus 5.5 (Xhigh) y GPT-6 Astra (Max) con 57. Todas las cifras salen de la página de metodología y de la página del Intelligence Index v5.0.
Qué es el Artificial Analysis Intelligence Index
Artificial Analysis mide modelos y APIs. Pasa a cada modelo el mismo conjunto de evaluaciones en las mismas condiciones y saca una media ponderada: eso es el Artificial Analysis Intelligence Index. La propia empresa dice que es una síntesis útil de la inteligencia general de un modelo, pero que, como cualquier métrica, tiene límites y puede no servir para todos los casos.
Dos cosas importantes. Todas las pruebas las ejecuta Artificial Analysis, no son cifras que publiquen los laboratorios. Y es una batería sobre todo en inglés y solo de texto: imagen, voz y otros idiomas se miden aparte y no cuentan en la nota. Si usas los modelos en español, no lo tomes como un ranking de español.
Las nueve evaluaciones y su peso
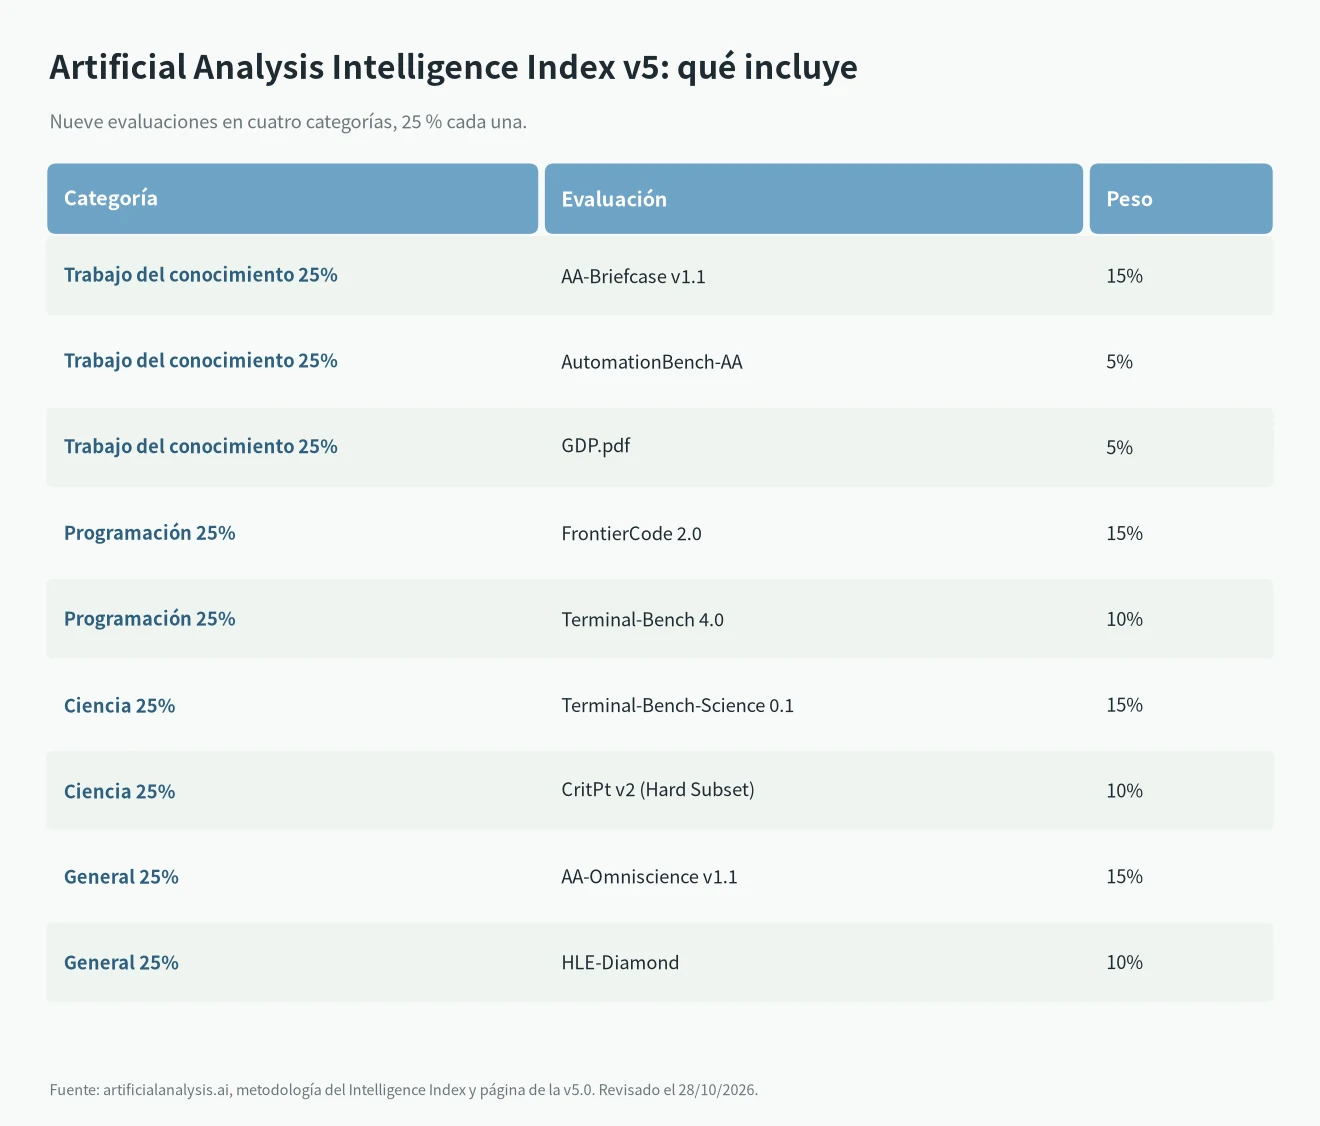
| Categoría | Evaluación | Peso | Qué mide |
|---|---|---|---|
| Trabajo del conocimiento | AA-Briefcase v1.1 | 15 % | 91 tareas de agente que generan archivos |
| Trabajo del conocimiento | AutomationBench-AA | 5 % | 657 tareas de automatización SaaS con APIs REST |
| Trabajo del conocimiento | GDP.pdf | 5 % | 100 tareas a partir de PDF largos |
| Programación | FrontierCode 2.0 | 15 % | 132 cambios de código en repositorios abiertos |
| Programación | Terminal-Bench 4.0 | 10 % | 66 tareas en terminal |
| Ciencia | Terminal-Bench-Science 0.1 | 15 % | 70 tareas en terminal de 5 áreas científicas |
| Ciencia | CritPt v2 (Hard Subset) | 10 % | 40 problemas difíciles de física |
| General | AA-Omniscience v1.1 | 15 % | 3.000 preguntas: precisión 10 %, no alucinar 5 % |
| General | HLE-Diamond | 10 % | 1.000 preguntas, mitad razonamiento, mitad conocimiento |
Lo que más me gusta es el componente de no alucinar: AA-Omniscience da un 5 % a uno menos la tasa de alucinación. Un modelo que admite que no sabe puntúa mejor que uno que se lo inventa.
Qué cambió en la v5
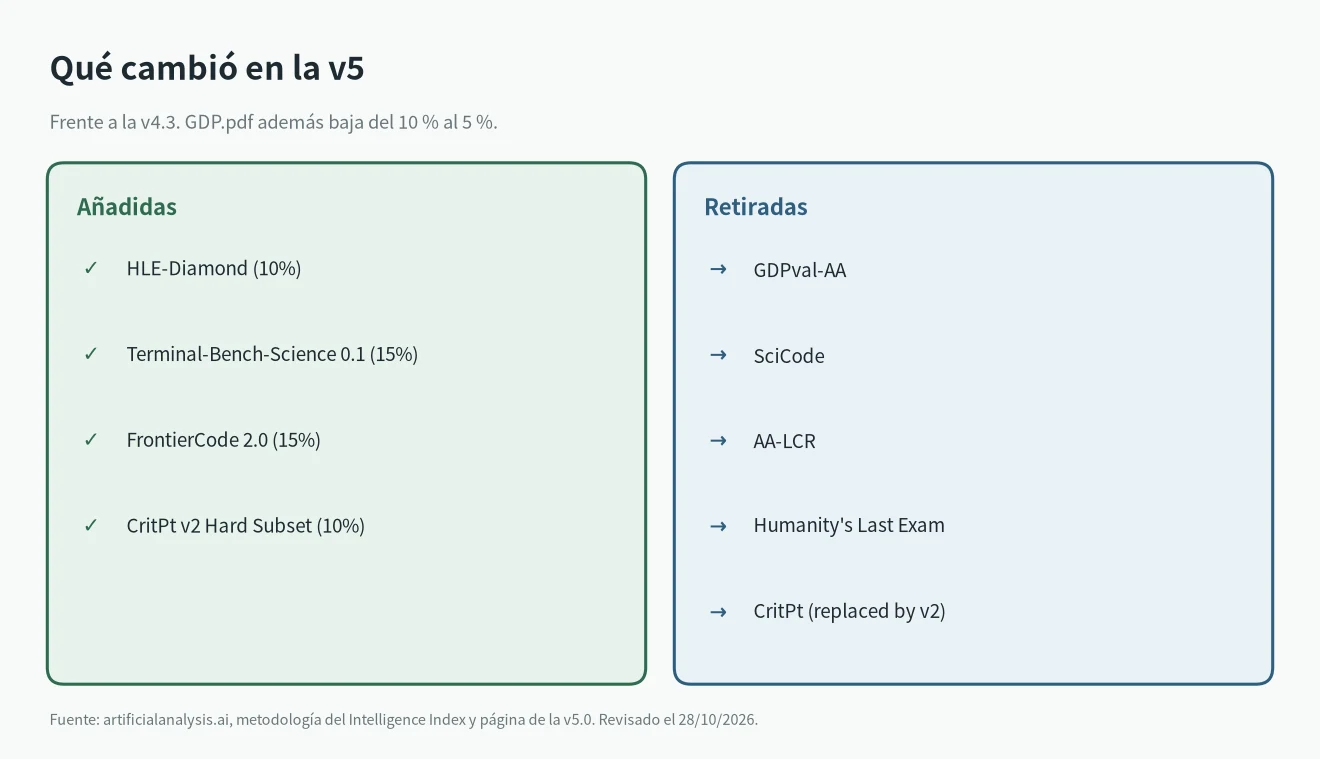
Según el historial de versiones oficial, la v5.0 añadió HLE-Diamond, Terminal-Bench-Science y FrontierCode 2.0. GDP.pdf bajó del 10 % al 5 %. CritPt pasó a CritPt v2 (Hard Subset) con el mismo 10 %. GDPval-AA, SciCode, AA-LCR y el Humanity’s Last Exam completo salieron del índice. La categoría Agents pasó a llamarse Knowledge Work y Scientific Reasoning pasó a Science.
En la práctica: las notas de la v5 salen de otras pruebas que las de la v4, así que no se comparan directamente. Si un modelo parece haber bajado de 70 y pico a 50 y pico, lo más probable es que haya cambiado la versión, no el modelo. Es mi lectura; Artificial Analysis no publica una tabla de conversión.
Quién va primero ahora
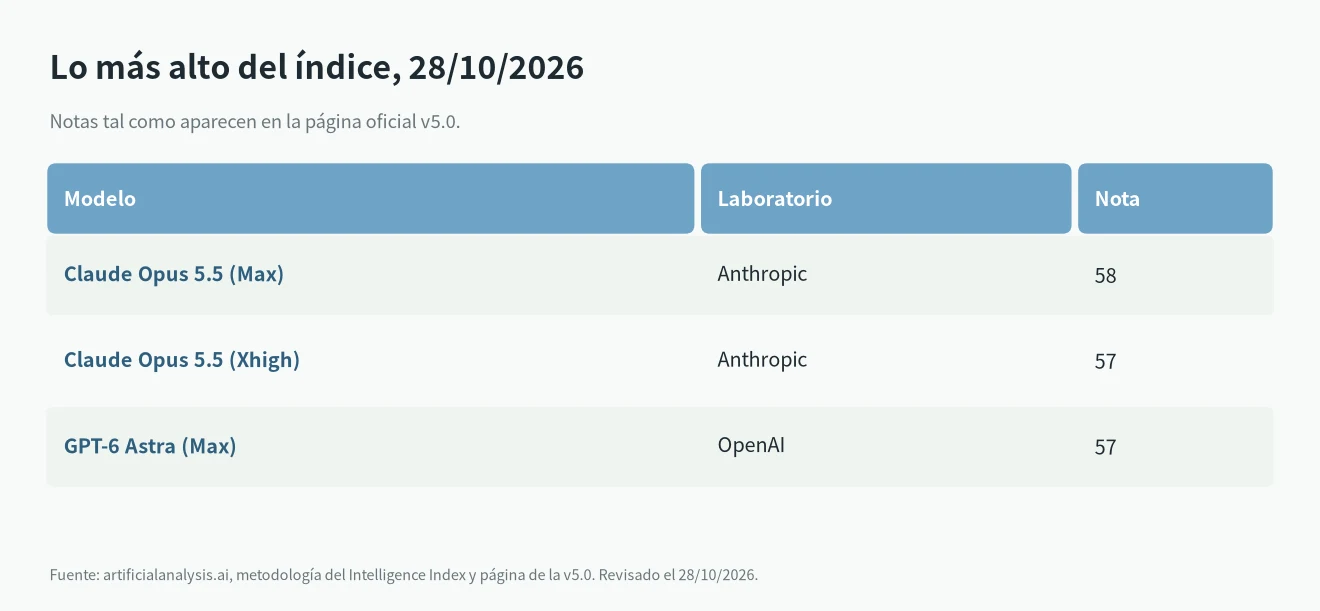
A 28 de octubre de 2026, la página oficial v5.0 indica que Claude Opus 5.5 (Max) tiene la nota más alta, 58, y que Claude Opus 5.5 (Xhigh) y GPT-6 Astra (Max) tienen 57. Los gráficos muestran 28 de 77 modelos.
En los datos de la página, el mejor modelo de pesos abiertos es DeepSeek V4.1 Flash, con unos 32,5, y Kimi K3.1 Pro ronda los 46. Para ver a fondo a los dos primeros, mira Opus 5.5 vs GPT-6.1 Sol; para precios de Kimi, precio de la API de Kimi K3.1 Pro.
Cómo se hacen las pruebas
- Mismas condiciones para todos los modelos del Artificial Analysis Intelligence Index: mismos prompts y criterios. Temperatura 0 en modelos sin razonamiento y 0,6 en modelos con razonamiento, salvo que el laboratorio recomiende otra.
- Zero-shot: instrucciones claras, sin ejemplos.
- Casi siempre pass@1, promediado cuando una prueba se repite.
- Los fallos de API se reintentan hasta 30 veces; si fallos persistentes afectan al resultado, no se publica.
Cómo leer la nota sin engañarse
Usa el Artificial Analysis Intelligence Index como primer filtro, no como veredicto.
- Una diferencia de 1 o 2 puntos es prácticamente un empate. En tu trabajo seguramente no notarás 58 frente a 57.
- Un mismo modelo aparece varias veces según el nivel de razonamiento, por ejemplo Max y Xhigh. Fíjate en cuál comparas: los niveles altos suelen costar más y tardar más.
- La misma página muestra coste por tarea, tokens de salida y tiempo por tarea. Con notas parecidas, una diferencia de coste de varias veces pesa más.
- Si quieres ejecutar modelos en local, mira las filas de pesos abiertos junto con mi guía de mejores LLM locales.
Preguntas frecuentes sobre el Artificial Analysis Intelligence Index
¿Cuál es la nota máxima?
Artificial Analysis no habla de un techo. Es una media ponderada de las evaluaciones y hoy lo más alto es 58, así que ni los mejores modelos lo bordan.
¿Cada cuánto cambia?
Los modelos nuevos entran cuando terminan las pruebas. La mezcla de evaluaciones cambia por versiones: en 2026 pasó de la v4.0 a la v5.0. El historial está al final de la página de metodología.
¿En qué se diferencia de los rankings por votos?
Puntúa tareas fijas que ejecuta la propia Artificial Analysis, sin votos de usuarios. Mide otra cosa; conviene mirar ambos.