

Opus 5.5 vs GPT-6.1 Sol: comparativa esencial, Opus gana por 3 puntos pero cuesta 8 veces más por tarea (2026)
Opus 5.5 vs GPT-6.1 Sol: Claude Opus 5.5 saca 58 y GPT-6.1 Sol 55 en el Intelligence Index v5 de Artificial Analysis, pero Opus cuesta 10,04 dólares por tarea frente a 1,27. Usa Sol por defecto y Opus para lo más difícil. Revisado el 28/10/2026.
 bufferSobre el autor5 min de lectura
En resumen: en el duelo Opus 5.5 vs GPT-6.1 Sol, Claude Opus 5.5 saca 58 puntos en el Intelligence Index v5 de Artificial Analysis y GPT-6.1 Sol saca 55, así que Opus es algo más capaz. Pero con las mismas tareas, Opus cuesta 10,04 dólares por tarea y Sol 1,27, casi 8 veces menos. Mi consejo: usa Sol para programar a diario y para la mayoría de tareas por API, y deja Opus para los trabajos más difíciles y largos. Los dos se probaron con el máximo esfuerzo de razonamiento; revisé los datos el 28 de octubre de 2026. Los precios de todos los proveedores están en mi comparativa de precios de API de LLM.
Pruebas: Opus gana 7, Sol gana 2
Artificial Analysis es una empresa independiente, así que no son cifras de los propios fabricantes. Su Intelligence Index v5 reúne 9 pruebas: trabajo de oficina, programación, uso de terminal, razonamiento científico y alucinaciones. El detalle completo está en la página de comparación de Artificial Analysis.
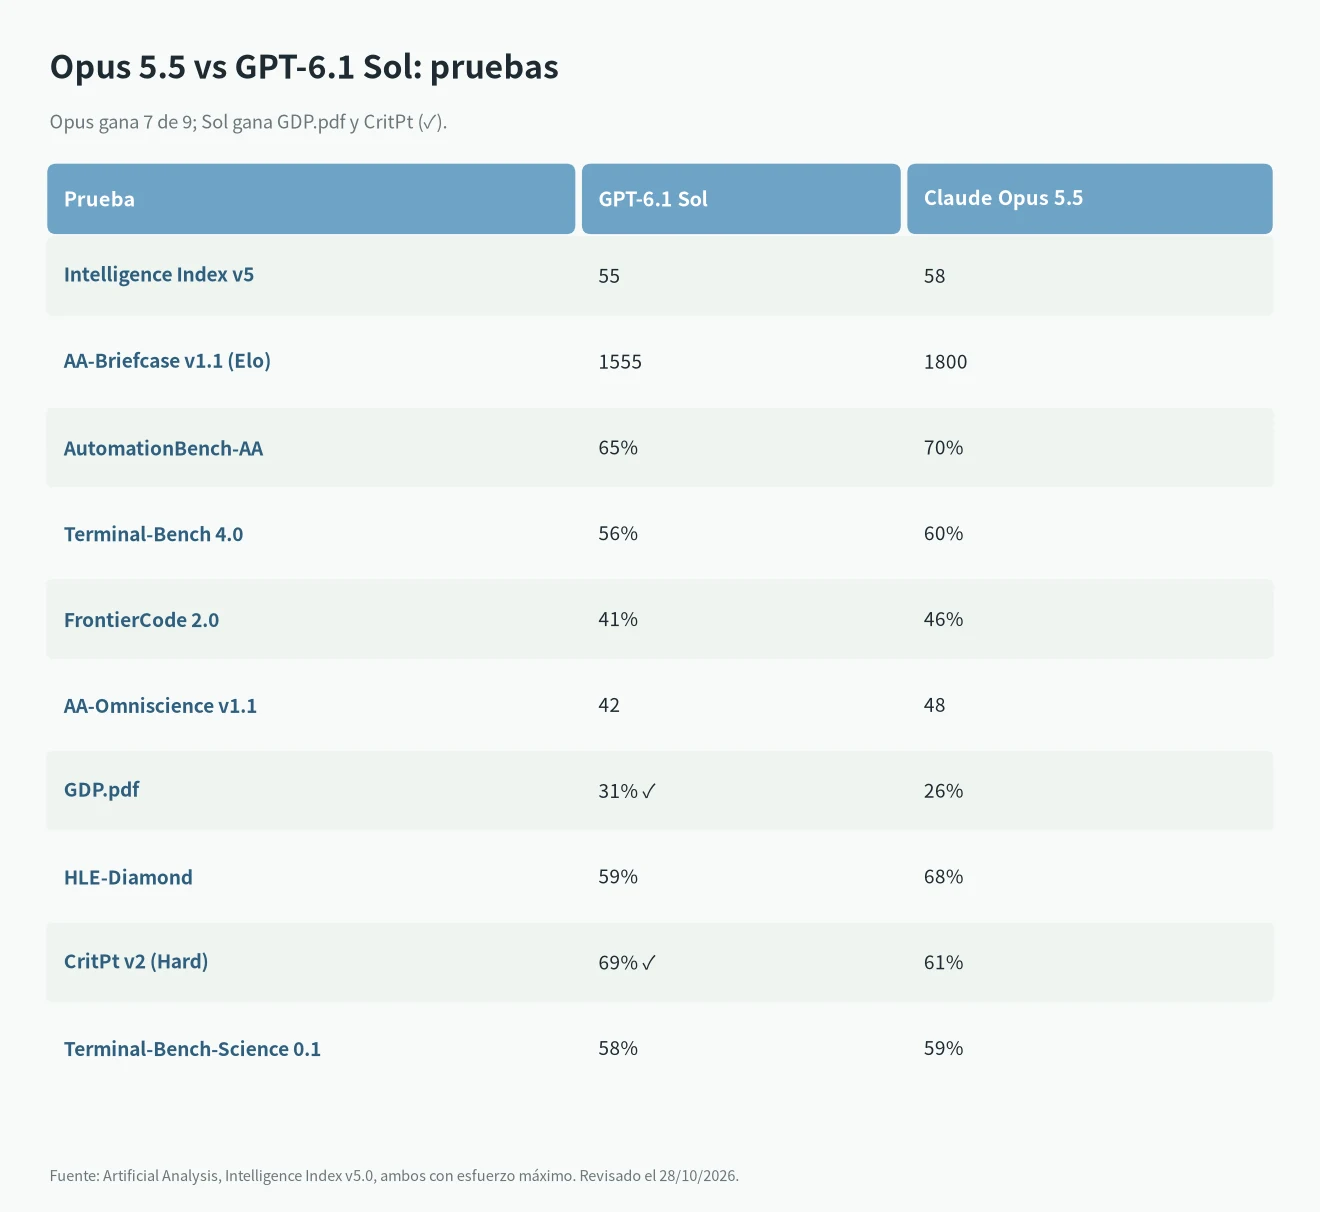
Opus 5.5 gana 7 de 9. Las mayores diferencias están en HLE-Diamond (68% frente a 59%) y AA-Omniscience (48 frente a 42). Omniscience castiga más una respuesta inventada que no responder, así que una nota más alta significa menos invenciones. En programación, Terminal-Bench 4.0 y FrontierCode 2.0, Opus saca entre 4 y 5 puntos más.
Las dos victorias de Sol no son pequeñas: 69% frente a 61% en CritPt v2, una prueba de investigación en física, y 31% frente a 26% en GDP.pdf, razonamiento sobre documentos. En Terminal-Bench-Science hay 1 punto de diferencia, prácticamente un empate.
En Opus 5.5 vs GPT-6.1 Sol, el 58 frente a 55 es una diferencia real, pero no tan grande como para que Opus sea obligatorio.
Precio: 2 veces por token, 8 veces por tarea
Precios oficiales por millón de tokens: Claude Opus 5.5 cuesta 4 dólares de entrada, 20 de salida y 0,20 en caché (precios de Anthropic). GPT-6.1 Sol cuesta 2 de entrada, 10 de salida y 0,10 en caché (página del modelo en OpenAI). Por token, Opus cuesta justo el doble.
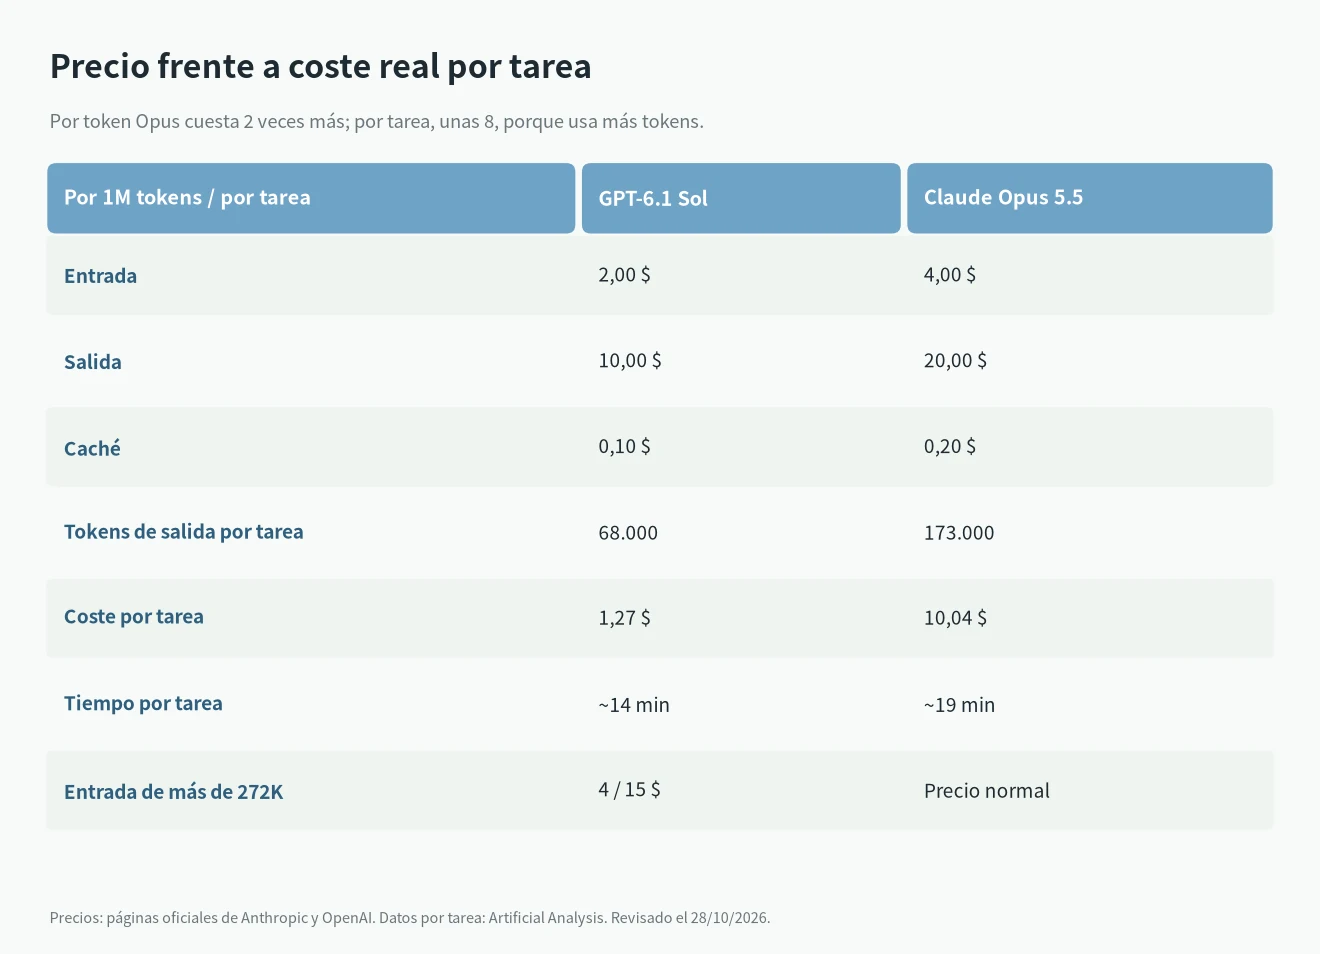
En Opus 5.5 vs GPT-6.1 Sol, la gran diferencia de coste está en cuántos tokens usa cada uno. Artificial Analysis midió una media de 173.000 tokens de salida por tarea en Opus, 120.000 de ellos de razonamiento. Sol usó 68.000, con 49.000 de razonamiento. El doble de precio por unas 2,5 veces más tokens da 10,04 frente a 1,27 dólares por tarea. Pasar el índice completo costó 8.910 dólares con Opus y 1.124 con Sol.
Un detalle: si un prompt de GPT-6.1 Sol supera los 272.000 tokens de entrada, toda la petición se cobra al doble en entrada y a 1,5 veces en salida, es decir, 4 y 15 dólares. Opus 5.5 cobra su contexto de 1 millón al precio normal. Con bases de código enteras o documentos muy largos, la diferencia se reduce. Batch rebaja los dos a la mitad.
Velocidad y contexto: Opus escribe más rápido, Sol termina antes
Opus 5.5 genera unos 98 tokens por segundo y Sol unos 81. Pero Opus piensa más: con esfuerzo máximo, el primer token tarda de media unos 700 segundos, frente a 278 en Sol. Por tarea, Sol termina en unos 14 minutos y Opus en unos 19.
El contexto es parecido: 1 millón de tokens en Opus 5.5 y 1,05 millones en Sol. Los dos permiten hasta 128.000 tokens de salida.
Opus 5.5 vs GPT-6.1 Sol: cuál usar
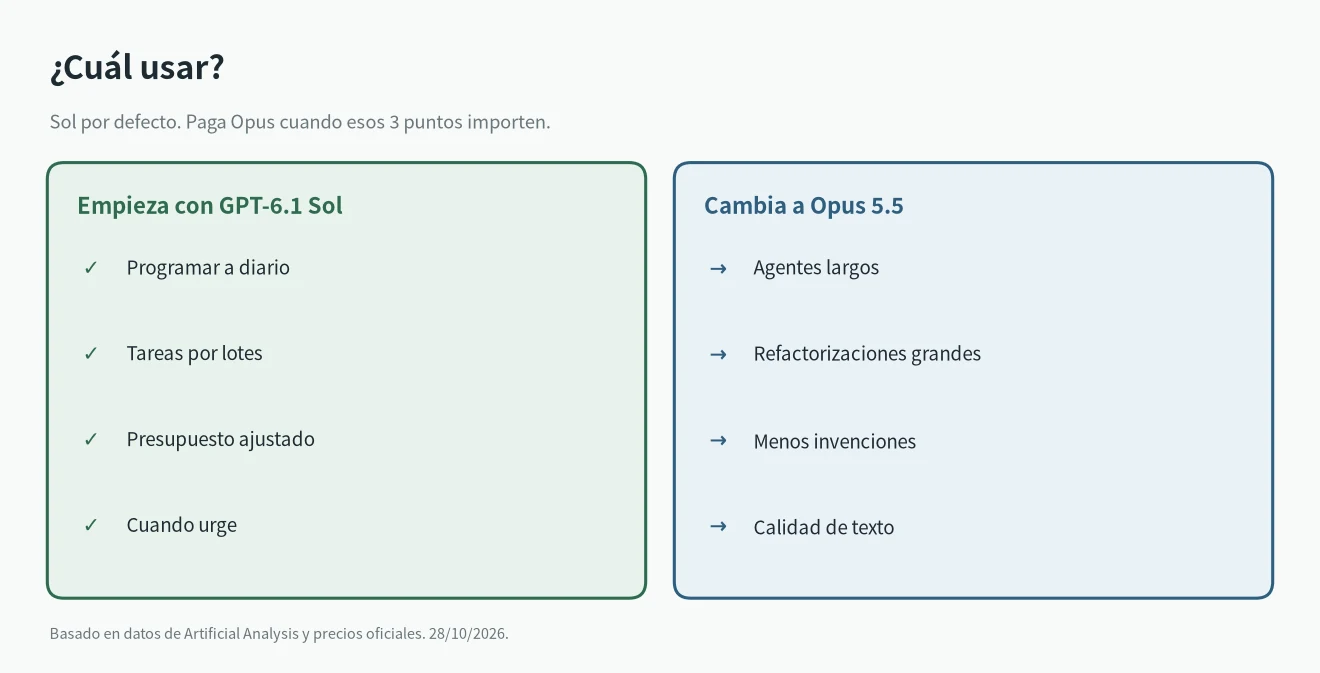
- Empieza con Sol para programar a diario, tareas por lotes en la API, presupuestos ajustados y cuando importa la rapidez.
- Cambia a Opus para agentes que trabajan solos mucho tiempo, refactorizaciones grandes y trabajos donde la precisión y la calidad del texto pesan más.
- Prueba los dos si tu trabajo se parece a CritPt o GDP.pdf, es decir, razonamiento científico o análisis de documentos. Ahí Sol puede ganar.
La prueba más sencilla de Opus 5.5 vs GPT-6.1 Sol: pasa 10 tareas reales tuyas por cada uno y compara resultados y factura.
Preguntas frecuentes
Tengo suscripción. ¿Cuál elijo?
Claude Code en Claude Pro y Max usa Opus 5.5 por defecto. Codex recomienda GPT-6.1 Sol para la mayoría de tareas de código. Las suscripciones se miden por límites de uso, no por tokens; comparo límites y precios en Claude Code o Codex.
Estas notas no coinciden con las del lanzamiento. ¿A cuál hago caso?
Las pruebas del lanzamiento las hace cada empresa con su propia configuración. Artificial Analysis prueba todos los modelos igual, así que sirve mejor para comparar. Aun así son solo 9 pruebas: prueba también tus propias tareas.
Claude Sonnet 5.5 cuesta lo mismo que Sol. ¿Lo tengo en cuenta?
Sí. Sonnet 5.5 también cuesta 2 dólares de entrada y 10 de salida. Si quieres seguir con Claude pero Opus te sale caro, prueba antes Sonnet 5.5 y compáralo con Sol.
Para seguir leyendo
Los precios de seis proveedores en una tabla están en la comparativa de precios de API de LLM. Lo que cuesta subir el esfuerzo de razonamiento en Claude Code está en Claude Code effort xhigh.
Artificial Analysis actualiza sus notas cuando cambian las pruebas. Actualizaré esta página cuando eso pase.