

Opus 5.5 vs GPT-6.1 Sol 哪个好?跑分只差 3 分,单任务成本却差 8 倍(2026 年 10 月实测数据)
Opus 5.5 vs GPT-6.1 Sol:Artificial Analysis 智能指数 v5 里 Claude Opus 5.5 是 58 分,GPT-6.1 Sol 是 55 分,但 Opus 每个任务 10.04 美元,Sol 只要 1.27 美元。日常先用 Sol,最难的活交给 Opus。2026 年 10 月 28 日核对。
 buffer关于作者约 4 分钟阅读
先说结论:Opus 5.5 vs GPT-6.1 Sol,按 Artificial Analysis 的智能指数 v5,Claude Opus 5.5 是 58 分,GPT-6.1 Sol 是 55 分,Opus 略强一点。但跑同一套任务,Opus 平均每个任务花 10.04 美元,Sol 只要 1.27 美元,差了快 8 倍。我的建议是:日常编码和大多数 API 任务先用 Sol,最难、最长的活再交给 Opus。两边都是开到最高推理强度(max)测的,数据在 2026 年 10 月 28 日核对。各家完整价格可以先看 大模型 API 价格对比。
跑分:Opus 赢 7 项,Sol 赢 2 项
Artificial Analysis 是第三方测评机构,不是这两家公司自己报的分。它的智能指数 v5 由 9 项测试组成,覆盖知识工作、编码、终端操作、科研推理和幻觉。完整对比在 Artificial Analysis 的对比页。
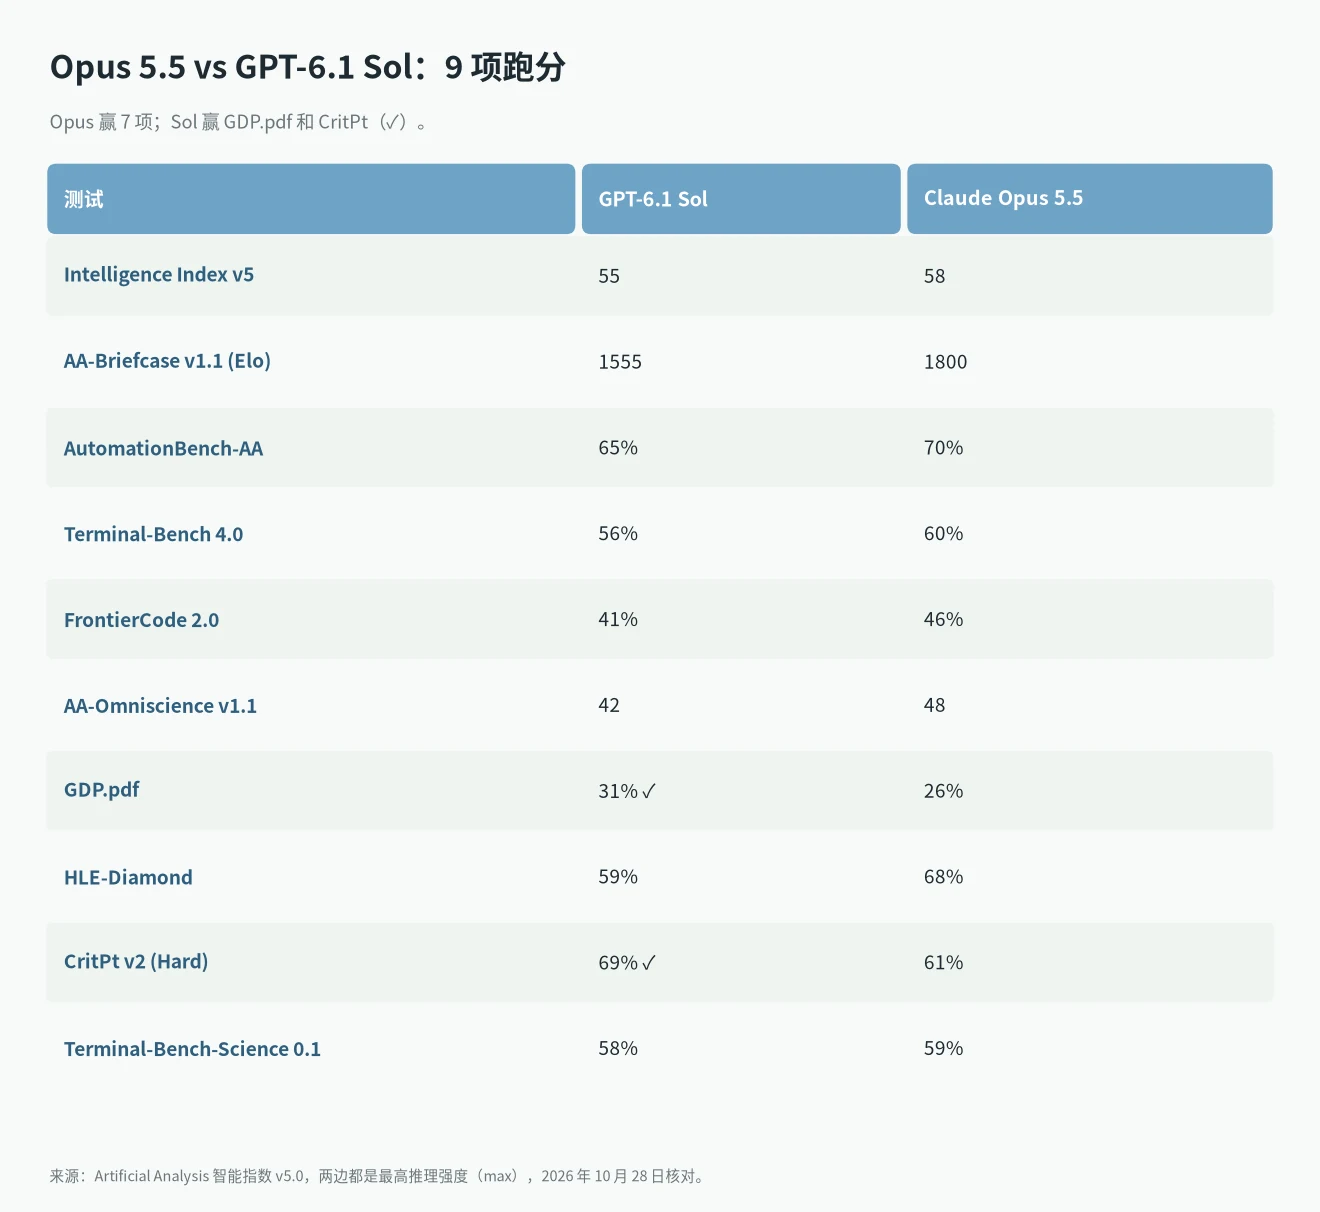
9 项里,Opus 5.5 赢了 7 项。差距最大的是 HLE-Diamond(68% 对 59%)和 AA-Omniscience(48 对 42),后者衡量“答错比不答更扣分”,Opus 的分高,说明它乱编的少一些。编码相关的 Terminal-Bench 4.0 和 FrontierCode 2.0,Opus 也各高 4 到 5 个点。
Sol 赢的 2 项也不小:CritPt v2 物理科研推理是 69% 对 61%,GDP.pdf 文档推理是 31% 对 26%。Terminal-Bench-Science 只差 1 个点,可以看作打平。
总分 58 对 55,差 3 分。这个差距真实存在,但没有大到“非 Opus 不可”。
价格:标价差 2 倍,单任务成本差 8 倍
官方标价(每百万 token):Claude Opus 5.5 输入 4 美元、输出 20 美元,缓存命中 0.20 美元,见 Anthropic 定价页;GPT-6.1 Sol 输入 2 美元、输出 10 美元,缓存命中 0.10 美元,见 OpenAI 模型页。按单价算,Opus 刚好贵一倍。
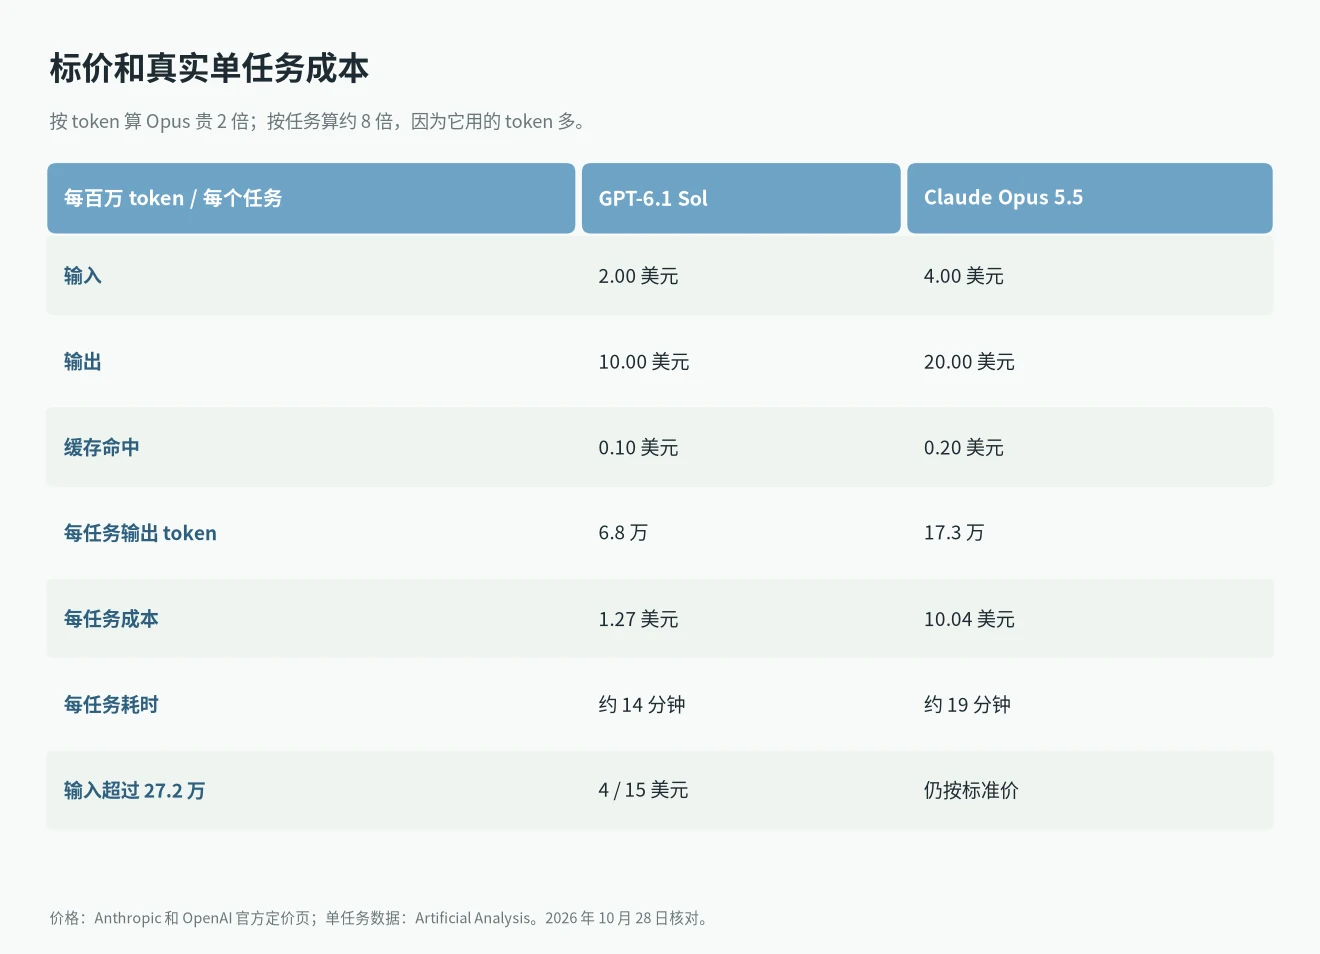
真正拉开差距的是 token 用量。Artificial Analysis 记录的每个任务平均输出:Opus 是 17.3 万 token,其中推理 12 万;Sol 是 6.8 万,推理 4.9 万。单价贵一倍,用量又多两倍半,结果就是每个任务 10.04 美元对 1.27 美元。整套指数跑下来,Opus 花了 8,910 美元,Sol 是 1,124 美元。
还有一个容易漏的点:GPT-6.1 Sol 的输入超过 27.2 万 token 时,整次请求输入按 2 倍、输出按 1.5 倍计费,也就是 4 和 15 美元。Opus 5.5 的 100 万上下文全程按标准价。所以喂整个代码库、超长文档的场景,两边的价差会缩小。两家的 Batch 都打五折。
速度和上下文:Opus 吐字快,Sol 先做完
Opus 5.5 每秒输出约 98 个 token,Sol 约 81 个,单看速度 Opus 快。但 Opus 想得更多,开到 max 时首个 token 平均要等 700 秒,Sol 是 278 秒。平均下来,Sol 做完一个任务约 14 分钟,Opus 约 19 分钟。
上下文两边差不多:Opus 5.5 是 100 万 token,Sol 是 105 万;最大输出都是 12.8 万 token。
Opus 5.5 vs GPT-6.1 Sol 怎么选
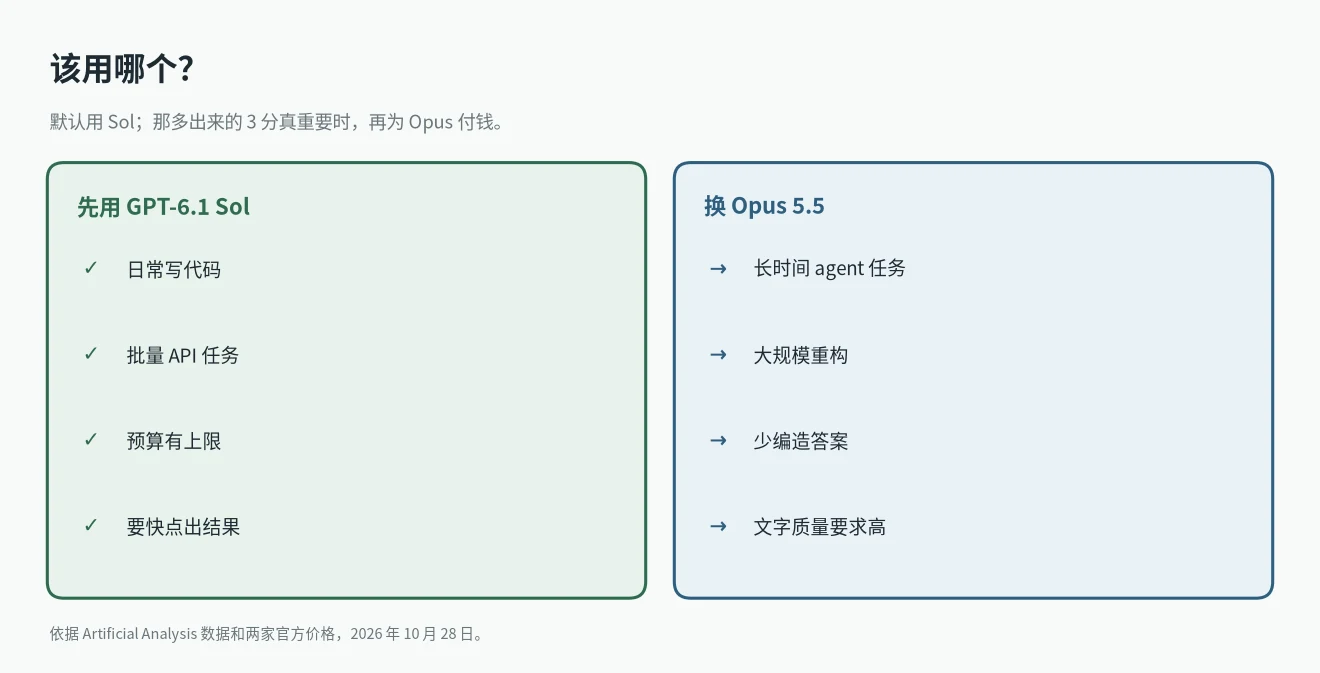
- 先用 Sol:日常写代码、批量跑的 API 任务、预算有上限、需要快点出结果。
- 换 Opus:长时间自己跑的 agent 任务、复杂代码库重构、对答案准确度和文字质量要求高。
- 两个都试:如果你的任务和 CritPt、GDP.pdf 这类科研推理、文档分析接近,Sol 不一定输。
最省事的办法是拿自己的 10 个真实任务各跑一遍,看结果和账单,再定主力。
常见问题
订阅用户怎么选?
Claude Pro 和 Max 上的 Claude Code 默认就是 Opus 5.5;Codex 官方推荐大多数编码用 GPT-6.1 Sol。订阅按额度算,不按 token 收钱,两边的额度和价格对比我写在 Claude Code 和 Codex 哪个好。
这个分数和官方宣传的不一样,信哪个?
官方发布时的跑分是自己测的,设置也不同。Artificial Analysis 用同一套测试、同一种方式测所有模型,更适合横向比。但它也只是 9 项测试,你的具体任务还是要自己试。
Claude Sonnet 5.5 和 Sol 同价,要不要考虑?
Sonnet 5.5 的官方标价也是输入 2 美元、输出 10 美元,和 Sol 一样。想留在 Claude 生态又嫌 Opus 贵,可以先试 Sonnet 5.5,再和 Sol 比。
相关阅读
想看六家模型的价格放在一张表里,看 大模型 API 价格对比;在 Claude Code 里调高思考强度会多花多少,看 Claude Code ultrathink 怎么用。
Artificial Analysis 的分数会随新测试更新,有变化我会改这篇。